Hinweis: Namen, Tabellenbezeichnungen und die Fachdomäne sind verändert, damit keine kundeninternen Details nach außen gelangen. Die technischen Rahmenbedingungen entsprechen dem echten Fall.
Ich komme aus der Oracle-Welt, Informix gehört nicht zu meinem Alltag. Trotzdem habe ich eine alte Informix-Datenbank wieder zum Sprechen bringen dürfen. Den größten Teil der Arbeit hat dabei die KI erledigt, mit opencode als Agent. Das Prüfen der Ergebnisse blieb bei mir und genau darum geht es in diesem Text.
Der Auftrag klang unspektakulär. Eine Datenbank, die bei einem Kunden jahrelang niemand angefasst hatte, sollte wieder lesbar werden: Welche Kunden hatten welche Bestellungen ausgelöst, was verkaufte sich gut, welcher Lagerbestand lag wo? Ein Rewrite oder eine Migration des Systems war ausdrücklich nicht gewünscht.
Dann kam die Überraschung. Im gesamten System gab es keinen einzigen Fremdschlüssel, und niemand konnte mir erklären, warum. Wie die Tabellen zusammenhingen, wussten nur die ursprünglichen Entwickler und die Anwendung selbst. Beide waren seit Jahren verschwunden. Also habe ich einen direkten Blick auf das Datenmodell geworfen. Eine Spalte kunde_nr in der Kundentabelle tauchte in der Bestelltabelle unter demselben Namen wieder auf. Das legt eine Beziehung nahe (PK / FK), beweist sie aber nicht. Beziehungsstatus: kompliziert.
Erst mal reinkommen
Bevor ich irgendetwas analysieren konnte, musste ich überhaupt mit der Datenbank reden können. Dafür brauchte es ein altes Linux-System mit einem uralten Unix-ODBC-Treiber. Diesen Umweg über einen Podman-Container hat bereits die KI aufgebaut, samt der gesamten Infrastruktur dahinter (Treiber und Co.). Der Zugriff war streng begrenzt: Der Agent durfte über den Container nur lesen, und zwar eine Anweisung pro Aufruf, ohne Ausnahme.
Spurensuche in drei Quellen
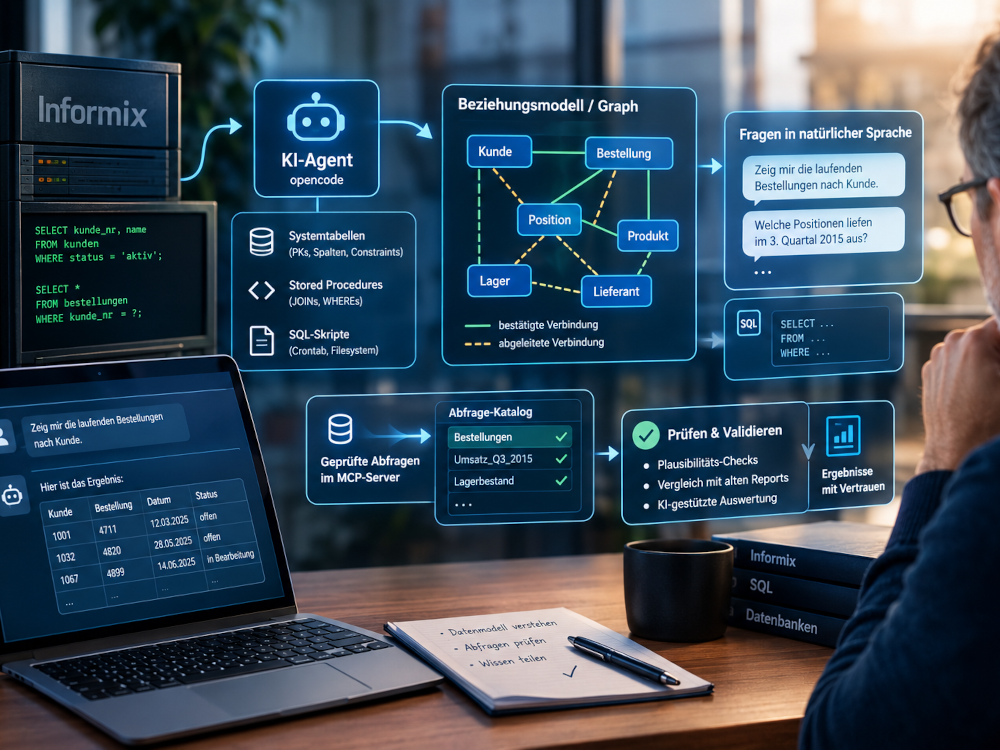
Als Erstes hat der Agent die Systemtabellen ausgewertet, also Tabellennamen, Spaltennamen und die Constraints (PKs), die tatsächlich hinterlegt waren. Das Ergebnis war ein erstaunlich dünnes, aber verlässliches Gerüst.
Danach hat er nach gespeicherten Prozeduren gesucht. Die alte Anwendung hatte einen Teil ihrer Logik direkt in der Datenbank abgelegt, und der Quelltext lag noch im Katalog. Der Agent hat ihn nach JOIN- und WHERE-Bedingungen durchsucht und jede Verknüpfung zwischen zwei oder mehr Tabellen festgehalten. So eine Verknüpfung ist ein besserer Beleg als jeder Spaltenname, denn sie hat einmal echten Code angetrieben.
Die dritte Quelle war Zufall. In der Crontab und im Dateisystem bin ich auf SQL-Skripte gestoßen, die früher gegen diese Datenbank gelaufen sind. Auch die habe ich nach JOIN- und WHERE-Kriterien auswerten lassen. Damit kam ein weiteres Stück des ER-Modells ans Licht.
Aus den Funden wird ein Graph
Aus all dem hat der Agent ein Beziehungsmodell gebaut, einen Graphen mit zwei Arten von Verbindungen. Bestätigte Verbindungen waren durch ein echtes Constraint oder echten Code belegt, abgeleitete (Namensgleichheit von Spalten) lagen nur wegen gleicher Namen nahe. Diese Unterscheidung war der eigentliche Wert des Modells, denn jede Abfrage bekam dadurch eine Vertrauensstufe. Lief eine Auswertung über bestätigte Verbindungen, konnte ich ihr glauben. Lief sie über abgeleitete, war Vorsicht angesagt.
Ein paar Gespräche mit Leuten, die die fachliche Seite des Systems noch kannten, haben das Bild abgerundet.
Vom Graphen zur Sprache
Ab da konnte ich Fragen in normaler Sprache stellen, etwa „Zeig mir die laufenden Bestellungen nach Kunde“ oder „Welche Positionen liefen im 3. Quartal 2015 aus?“. Zehn Tabellennamen samt Verknüpfungen musste ich nicht mehr im Kopf haben. Um den SQL-Dialekt von Informix hat sich ebenfalls die KI gekümmert und ich gebe zu: Als Oracler habe ich mir diese Lektüre gern erspart. Das war ehrlich beeindruckend.
Abfragen, die sich bewährt hatten, haben wir in einem kleinen Katalog gesammelt und über einen MCP-Server bereitgestellt. So kann jeder weitere KI-Agent später auf geprüfte Abfragen zurückgreifen, statt bei null anzufangen. Dort landet bewusst nicht jede Abfrage, die je gestellt wurde, sondern nur die brauchbaren. Wir kuratieren, wir protokollieren nicht. Dazu haben wir einfach schnell einen Skill geschrieben, den wir bewusst angesprochen haben: „Merk dir und dokumentiere dieses SQL unter dem Namen ‚Bestellungen‘.“
Der eigentliche Job: prüfen
Die KI lieferte in Minuten einen plausiblen ersten Treffer. Ob er stimmte, war eine andere Frage, und das Durchprüfen war die eigentliche Arbeit. Zum Glück gab es einige alte PDF-Reports, gegen die wir die Plausibilität (natürlich wieder mit KI) geprüft haben. Dazu haben wir einfach versucht, einen Umsatzreport nachzuprompten, den wir als PDF hatten. Erfolgreich!
Das ganze Projekt habe ich dank KI, vom Aufbau der Infrastruktur bis zur Übergabe des MCP-Servers, an einem Tag erledigen können. Hätte ich das manuell auch lösen können? Sicher! An einem Tag? Sicher nicht!
Wann habt ihr zuletzt per KI mit einer Datenbank gesprochen?
Matthias Jung